Свой сервер нейросети позволяет запускать модели внутри собственной инфраструктуры, хранить данные локально и самостоятельно управлять вычислительными ресурсами. Такой подход используют для корпоративных LLM, обработки документов, аналитики, компьютерного зрения, генеративного ИИ и обучения собственных моделей.
При этом свой сервер для нейросети не обязательно должен состоять из восьми мощных GPU. Для локального инференса может быть достаточно одного или двух ускорителей, а для обучения крупных моделей потребуется уже полноценная multi-GPU платформа. Конфигурацию имеет смысл рассчитывать от самой модели и реальной нагрузки.
Когда свой сервер для нейросети имеет смысл
Собственная инфраструктура особенно интересна, когда нейросеть используется постоянно, а не запускается несколько раз в месяц для экспериментов.
Свой сервер обычно выбирают, если:
- модель работает ежедневно;
- необходимо хранить корпоративные данные внутри инфраструктуры компании;
- запускаются локальные LLM;
- требуется fine-tuning на собственных данных;
- к модели одновременно обращаются несколько пользователей или сервисов;
- нагрузка достаточно стабильна и прогнозируема;
- в дальнейшем планируется масштабирование AI-инфраструктуры.
Главное отличие от облака здесь не только в стоимости. Компания получает постоянный доступ к своим вычислительным ресурсам и сама определяет, какие модели, библиотеки и программный стек будут использоваться.
Что нужно для запуска нейросети на своем сервере
В первую очередь необходимо оценить требования модели к видеопамяти. Чем крупнее модель, больше контекст и выше число одновременных запросов, тем больше VRAM потребуется.
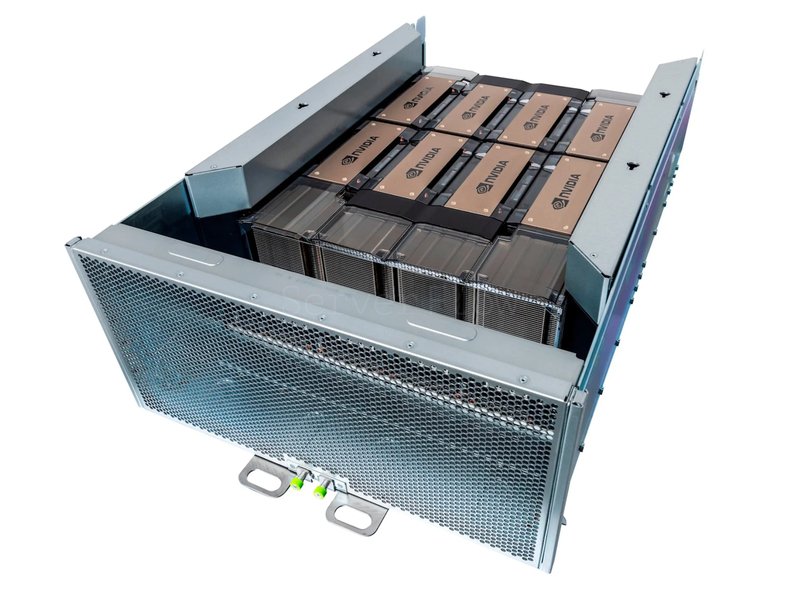
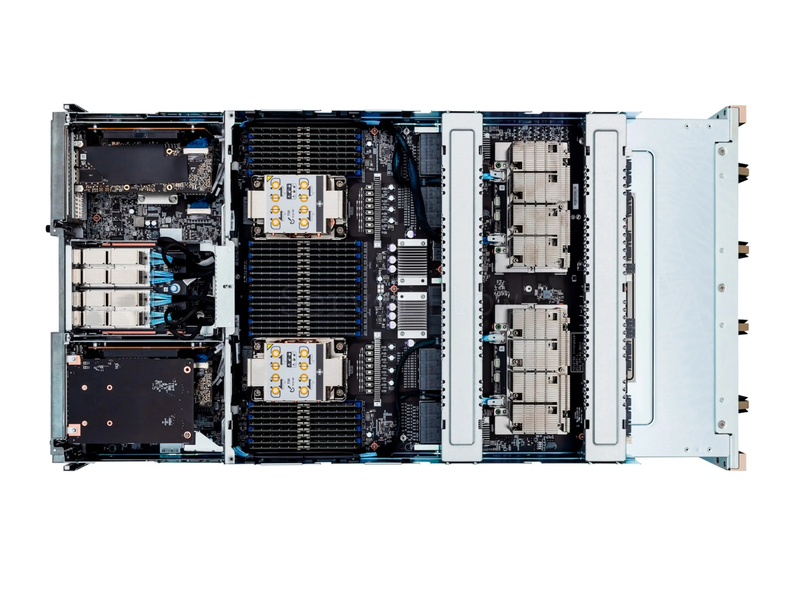
Для тяжелых AI-нагрузок используются серверные ускорители. Например, NVIDIA H100 80GB SXM подходит для обучения LLM, инференса и multi-GPU систем. Если требуется больший объем памяти на один ускоритель, можно использовать NVIDIA H200 141GB SXM.
Но GPU — только часть конфигурации. Для стабильной работы также важны:
- производительные CPU;
- достаточный объем RAM;
- быстрые NVMe-накопители;
- пропускная способность сети;
- питание и охлаждение;
- возможность дальнейшего расширения системы.
Если данные медленно поступают с накопителей или CPU не успевает обслуживать вычислительный процесс, часть производительности GPU просто не используется.
Сколько GPU нужно
Заранее покупать максимально возможное количество видеокарт не всегда рационально.
Одна GPU может использоваться для разработки, тестирования и локального инференса моделей, которые помещаются в память одного ускорителя.
Две-четыре GPU дают больше видеопамяти и вычислительной мощности. Такие системы подходят для более крупных моделей, fine-tuning и увеличения количества параллельных запросов.
Восемь GPU — уже класс серверов для тяжелого обучения, крупных LLM и HPC. Здесь становится особенно важной скорость обмена между ускорителями.
Например, Supermicro SYS-821GE-TNHR построен на платформе NVIDIA HGX H100/H200 с восемью SXM GPU и использует NVLink с NVSwitch для быстрого межGPU-обмена.
Количество GPU поэтому нужно определять не отдельно, а вместе с требованиями модели к памяти и архитектурой ее запуска.
Свой сервер нейросети или облако
Облачный GPU удобен, если нагрузка возникает периодически. Можно арендовать необходимые вычислительные ресурсы на время тестирования, обучения или отдельных проектов и не содержать собственное оборудование.
При постоянной нагрузке ситуация меняется. Собственный сервер позволяет заранее знать доступный объем ресурсов, не зависеть от наличия нужных GPU у облачного провайдера и самостоятельно контролировать хранение данных.
Возможен и гибридный сценарий: основные модели работают локально, а облачные GPU используются при временном увеличении нагрузки или для отдельных вычислительных задач.
Поэтому вопрос обычно заключается не в том, что лучше в принципе — свой сервер или облако, а в том, насколько регулярно используется оборудование и какие требования предъявляются к данным и инфраструктуре.
Как подобрать конфигурацию
Расчет своего сервера для нейросети лучше начинать не с конкретного корпуса или видеокарты, а с четырех вопросов:
- Какая модель будет запускаться?
- Сколько видеопамяти ей требуется?
- Это инференс, fine-tuning или полноценное обучение?
- Сколько пользователей или процессов будут работать одновременно?
После этого можно определять количество GPU, объем RAM, конфигурацию NVMe и требования к сети.
Если проект будет развиваться, стоит заранее предусмотреть запас для масштабирования. Но он должен быть обоснованным: правильно подобранный сервер — это не максимальная конфигурация, а система, ресурсы которой соответствуют реальной нагрузке.
Вывод
Свой сервер для нейросети имеет смысл, когда AI становится постоянным рабочим инструментом компании. Он дает контроль над вычислительными ресурсами и данными, позволяет локально запускать модели и постепенно масштабировать инфраструктуру.
В GetCore можно подобрать GPU-сервер под локальные LLM, инференс, fine-tuning или обучение — от систем с одной или несколькими GPU до многоGPU платформ на NVIDIA H100 и H200.